希爾貝殼 做好AI數據基礎服務,實現人工智能民主化,我們任重而道遠
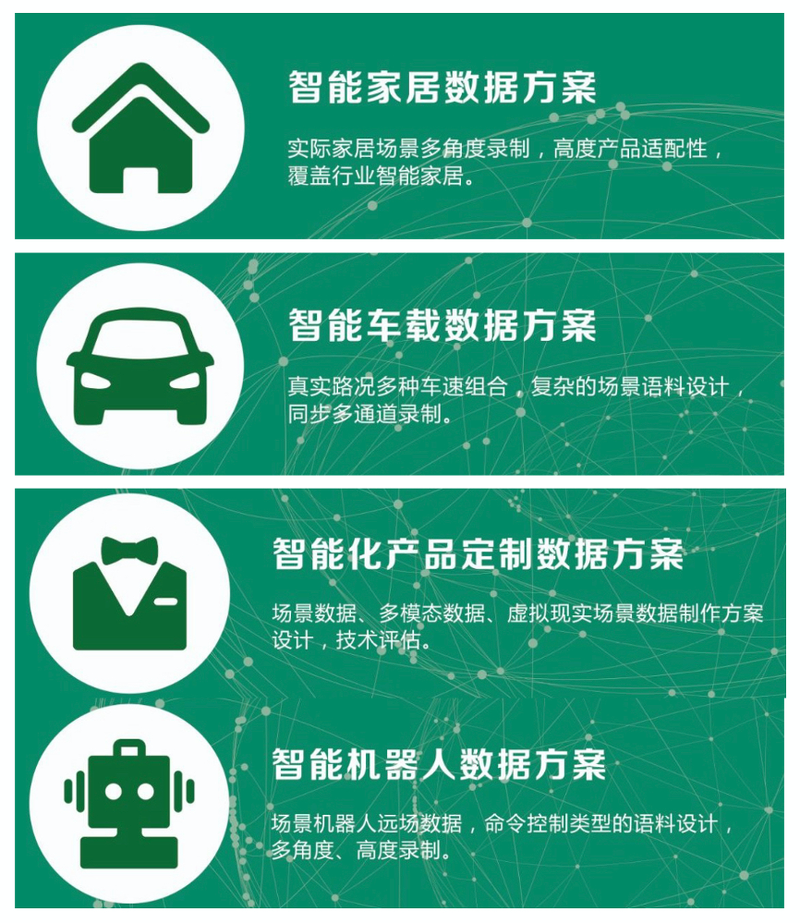
在人工智能浪潮席卷全球的今天,算法的迭代與算力的提升吸引了絕大多數目光,支撐這一切的基石——數據,尤其是高質量的數據基礎服務,卻往往被忽視。希爾貝殼作為一家專注于人工智能基礎軟件開發的企業,深知數據是AI的“燃料”,而數據基礎服務的質量直接決定了AI應用的高度與廣度。我們的使命,正是做好AI數據基礎服務,推動人工智能的民主化進程,讓更多組織和個人能夠平等地享受AI技術帶來的紅利。
人工智能民主化,意味著AI技術不應是少數科技巨頭的專利,而應成為千行百業、乃至每一個開發者都能便捷使用的工具。要實現這一目標,首先需要解決數據的可用性、可靠性與經濟性問題。當前,AI項目在數據層面面臨諸多痛點:數據采集成本高、標注質量參差不齊、隱私合規風險大、數據孤島現象嚴重。這些問題導致許多有創意的AI想法因數據門檻而夭折,也使得中小企業和研究機構在AI競爭中處于劣勢。希爾貝殼從基礎軟件開發入手,構建了一套完整的數據基礎服務平臺,旨在通過自動化、智能化的工具鏈,降低數據準備的門檻和成本,讓數據“活”起來。
我們的核心工作聚焦于幾個關鍵方向。第一,數據采集與清洗的自動化。傳統的數據采集依賴人工,效率低下且易出錯。我們開發了智能爬蟲與傳感器數據接入框架,能夠從多源異構數據中高效提取有效信息,并利用機器學習算法自動進行數據清洗、去重和標準化,大幅提升數據預處理效率。第二,數據標注的智能化。標注是監督學習的關鍵環節,但純人工標注成本高昂且質量不穩定。希爾貝殼推出了半自動標注平臺,結合主動學習與預標注模型,讓標注員只需處理最不確定的樣本,從而將標注效率提升數倍,同時保證標注一致性。第三,數據隱私與安全計算。我們提供了基于聯邦學習與差分隱私的數據協作工具,讓不同機構能夠在不出域的前提下聯合建模,既保護了數據隱私,又打破了數據孤島。第四,數據版本管理與可復現性。AI模型的可復現性危機往往源于數據版本混亂。希爾貝殼的數據版本控制系統(類似Git for Data)讓團隊能夠追蹤數據集的每一次變更,確保實驗可復現,加速模型迭代。
這些基礎軟件的開發并非易事。我們面臨技術挑戰、生態挑戰與商業挑戰。技術上,需要處理海量數據的實時處理與存儲,保證系統的高可用與可擴展性;生態上,需要與主流AI框架(如TensorFlow、PyTorch)無縫集成,并推動行業數據標準的建立;商業上,需要找到可持續的商業模式,讓數據基礎服務既能普惠,又能支撐企業生存。希爾貝殼選擇開源與商業化并行的道路:核心基礎工具開源,降低使用門檻;企業級服務提供額外支持與保障,反哺開源社區。
實現人工智能民主化,我們任重而道遠。這一愿景要求我們不僅提供工具,更要構建生態。希爾貝殼將繼續深耕AI基礎軟件,聯合高校、企業、開發者社區,共同打造開放、可信、高效的數據基礎設施。我們相信,當數據基礎服務不再是AI創新的瓶頸,當每一個有想法的人都能輕松獲取和利用數據,人工智能才能真正惠及全人類。這條路漫長而艱辛,但每一步都值得。希爾貝殼愿做這座橋梁,連接數據與智能,連接現在與未來。
如若轉載,請注明出處:http://www.cnguge.com/product/48.html
更新時間:2026-09-29 09:24:20